隐私:录音一步都不出你的电脑
完全离线识别
这是 Handy 和所有云端听写工具最根本的区别。语音识别在你的电脑上完成,音频片段不会被发送到任何服务器。云端方案必须上传才能识别,而 Handy 连这一步都不存在。
断网照样能用
模型第一次下载后缓存在本地,之后完全离线工作。飞机上、地下室、涉密会议室、内网环境——只要电脑能跑,Handy 就能用。
会议与客户信息不外流
商务会议的内容、医生问诊的记录、客户的私密对话——这些录音一旦上传到第三方服务器,就不再由你控制。Handy 从机制上排除了这个风险。
没有账号,没有遥测
不需要注册、不需要联网激活、没有使用数据上报。代码完全公开可审查(MIT 许可),它到底做了什么、没做什么,看源码就知道。
交互:按住说话,松手出字
快捷键触发
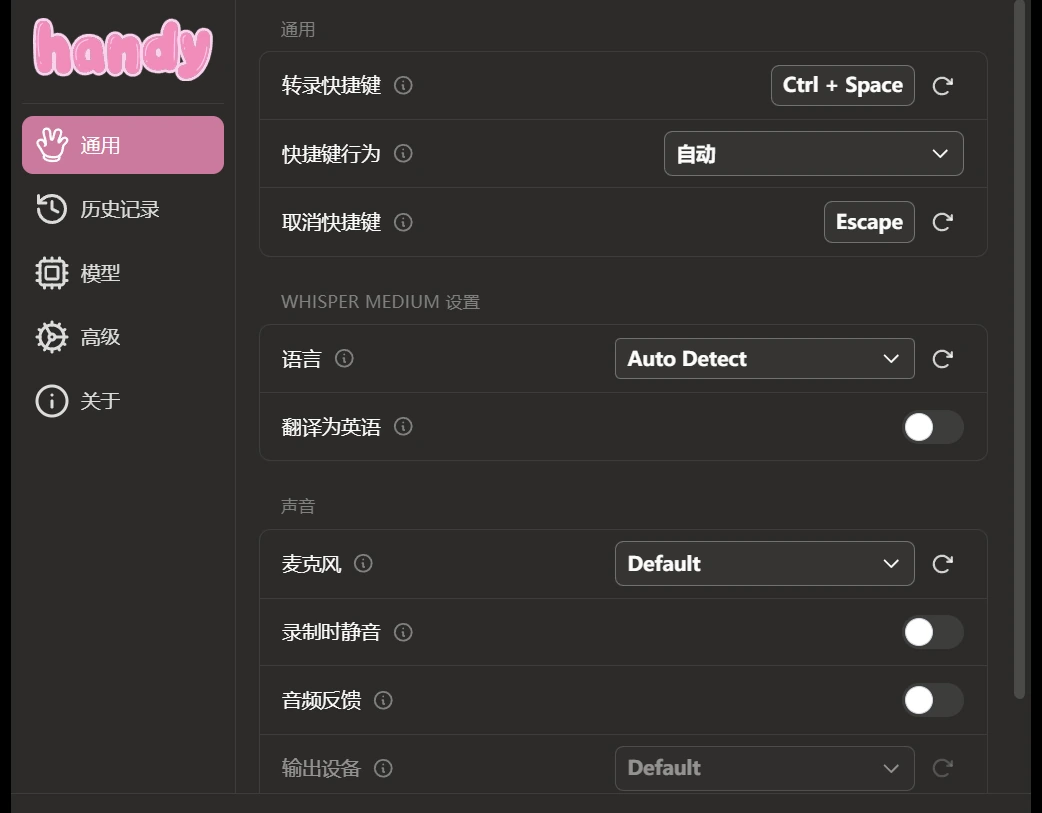
默认 Ctrl + Space(macOS 是 Command + Space)。按住说话,说完松手,识别结果直接落在你当前光标的位置——不需要切窗口、不需要复制粘贴、不需要等一个「上传中」。
实时字幕浮层
录音过程中屏幕上会实时显示转写内容。说完看一眼就知道识别对不对,不用等全部转完才发现中间某段跑偏了。
融入既有工作流
因为结果是直接插入光标处的,它天然适配任何编辑器、聊天窗口、邮件、文档。写邮件、回消息、记笔记——动嘴比动手快。
准确:把口头语变成能用的文字
语音活动检测
内置 VAD(Voice Activity Detection),识别时会自动跳过停顿和静音段。你不需要刻意保持「一直在说话」的状态,自然停顿不会被转成奇怪的标点或重复内容。
语气词过滤
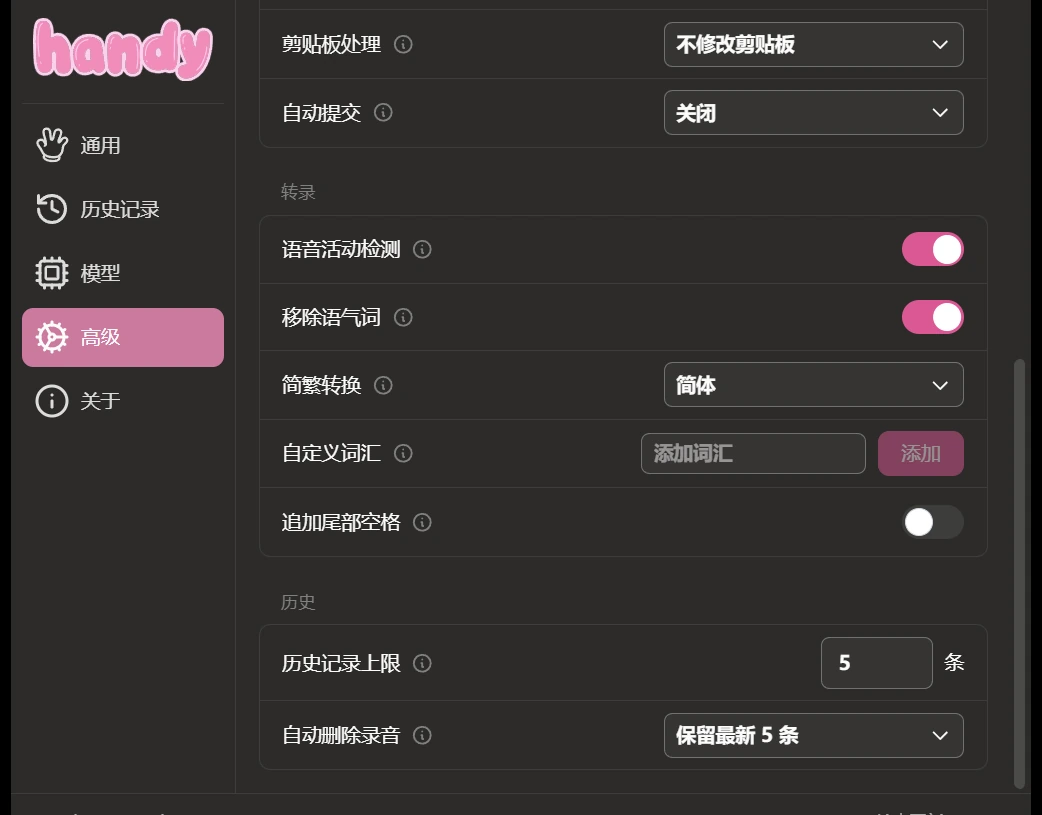
「嗯」「啊」「那个」这类口头禅可以在设置里一键移除。转出来的文字直接就能发出去,不用再手动删一遍。
自定义词典
把产品名、人名、专有名词加进自定义词典,识别时会优先用你给的写法。对经常要写特定术语的人(开发者、医生、律师)非常实用。
中文识别与简繁转换
可选模型支持上百种语言,中文识别准确率高。设置里能指定输出简体还是繁体;中英混说时也能自动判断当前该用哪种。
模型:按你的机器挑
多档模型可选
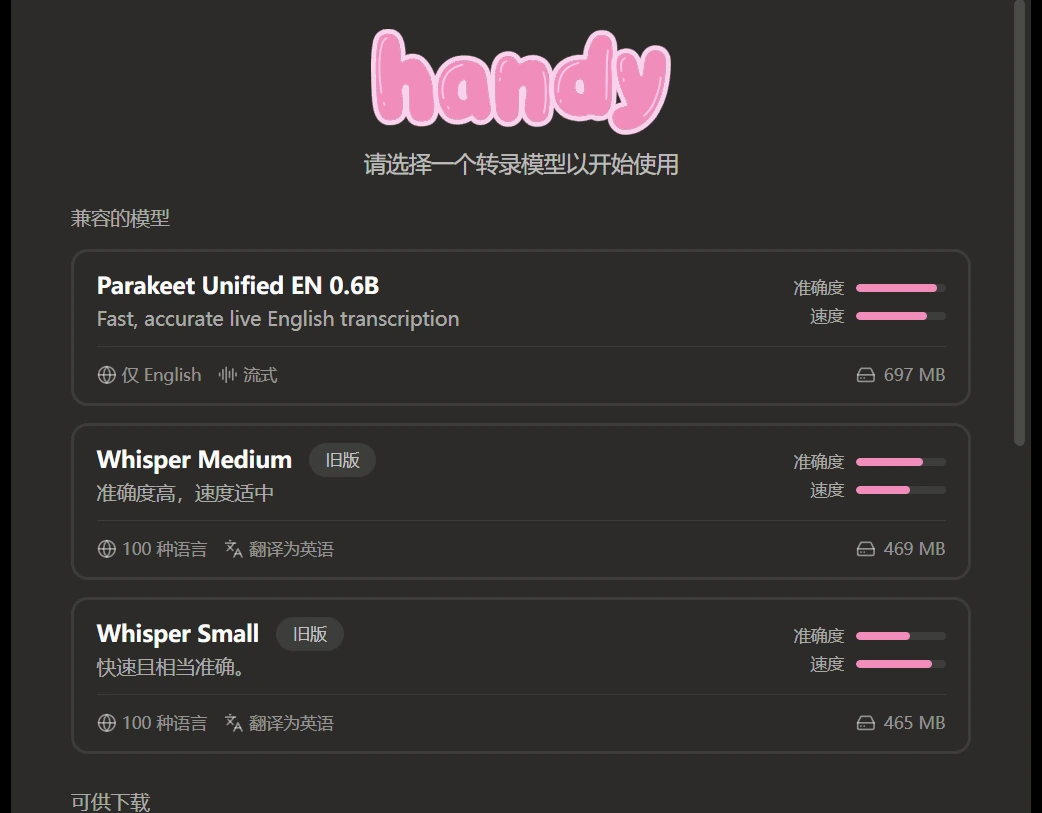
从轻量到高精度有多档模型可选。轻量模型几十 MB,集成显卡的老机器也能实时跑;高精度模型体积大但准确率高,适合有独显的机器或对准确率要求高的场合。
Whisper 系列可选
底层是 Whisper 系列模型,这套模型的 multilingual 能力经过大量验证,是目前开源语音识别里最被认可的方案之一。有独显的机器可以走 GPU 加速,识别速度提升明显。
模型缓存本地
下载过的模型缓存在本地,之后不再需要网络。模型体积换来的是不依赖任何服务器——这是隐私与便利的交换,而 Handy 让你自己选择档位。
为什么选开源版本
MIT 许可,改造成本低
MIT 是最宽松的开源许可之一,可以商用、可以修改、可以闭源分发。想要自己加个快捷键、改个界面输出方式,都不受限制。
没有付费版与会员
没有「免费版每天限 10 分钟」这种设计,也没有会员等级。云端听写工具常见的「按分钟计费」「免费额度有时长上限」,在 Handy 这里都不存在。
无广告无捆绑
装完打开就是能用的工具,不塞浏览器、不推会员、不弹推广。
活跃维护
项目在持续更新,模型支持、跨平台适配、界面都在不断改进。